Grip op Sport doet veel: leden, lessen, abonnementen, facturen, wedstrijden, verloning, boekhouding. Dat is fijn als alles staat, maar het inrichten kost tijd. De handleiding is uitgebreid: 124 schermen, bijna 900 secties uitleg, in 11 talen. Alleen moet je wel weten waar je moet zoeken.
Daarom bouwen we een AI-assistent die je in de software zelf kunt vragen hoe iets werkt. Je typt "hoe stel ik de contributie voor jeugdleden in?" en krijgt een kort antwoord, met een link naar precies het scherm waar je het regelt.
Geen eigen model trainen: RAG
We trainen geen eigen AI. Dat is duur, en elke wijziging in de software zou opnieuw training vragen. In plaats daarvan gebruiken we RAG (Retrieval-Augmented Generation). Bij elke vraag zoeken we eerst de stukken uit de handleiding die erbij passen, en geven die mee aan het taalmodel. Het model schrijft het antwoord alleen op basis van die bronnen. Staat het er niet in, dan zegt het dat eerlijk.
Het voordeel: passen we de handleiding aan, dan weet de assistent het na de volgende indexering meteen.
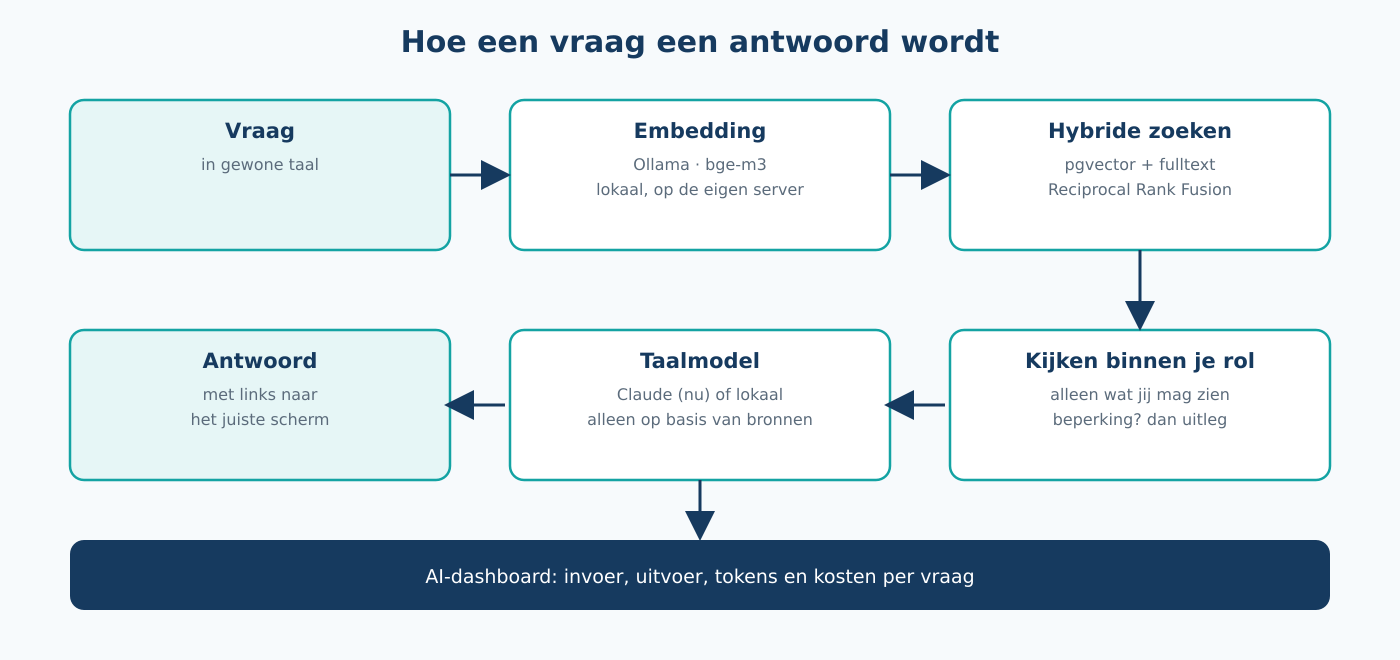
Hoe een vraag een antwoord wordt
- Embedding. De vraag wordt omgezet in een vector met bge-m3, een meertalig model dat lokaal draait in Ollama. Een vraag in het Pools vindt zo ook de Nederlandse uitleg.
- Hybride zoeken. In PostgreSQL met pgvector zoeken we op betekenis (vectoren) en op woorden (fulltext) tegelijk, en voegen we de resultaten samen met Reciprocal Rank Fusion. Zo vindt "waar zet ik de contributie" ook het scherm waar dat woord letterlijk staat.
- Kijken binnen je rol. Alleen stukken over schermen waar jij recht op hebt, gaan als bron mee. Vraag je naar iets waar je rol geen toegang toe heeft, dan legt de assistent uit welk recht nodig is en wie dat regelt.
- Taalmodel. Het model schrijft een kort, praktisch antwoord in jouw taal, met Markdown-links naar de schermen.
- Veilig tonen. HTML van het model wordt nooit uitgevoerd. Alleen links binnen de eigen software blijven klikbaar.
Zoeken duurt ongeveer 0,2 seconde. Het hele antwoord staat er met Claude Haiku binnen een paar seconden.
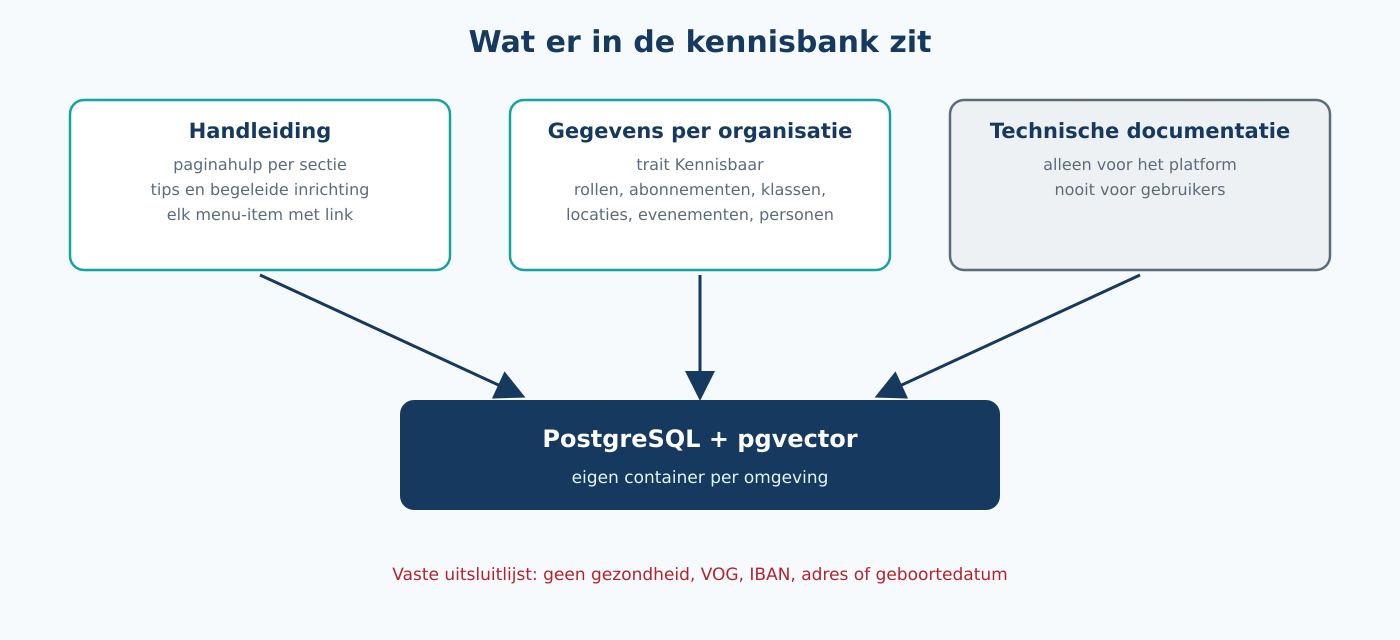
Wat er in de kennisbank zit
- De handleiding: de uitleg per scherm, de tips, de begeleide inrichting en elk menu-item met zijn link. Samen zo'n 1.200 stukken.
- Gegevens van je eigen organisatie: rollen met hun rechten, abonnementen, klassen, locaties, evenementen en personen. Een model doet mee door de trait
Kennisbaarte gebruiken en zelf op te geven welke velden erin mogen. Zo kan de assistent concreet zeggen welk abonnement je hebt of welke rol facturen mag maken. - Technische documentatie: alleen voor ons eigen platformteam, nooit voor gebruikers.
Twee regels houden dit veilig. Zoeken blijft altijd binnen je eigen organisatie. En de vectordatabase levert alleen kandidaten: de inhoud die naar het model gaat, komt vers uit de gewone database, met dezelfde rechtencontrole als in de app. Wat je in de app niet ziet, ziet de assistent ook niet. Gevoelige gegevens, zoals gezondheid, VOG, IBAN, adres en geboortedatum, staan op een vaste uitsluitlijst en komen er nooit in.
Meten wat het doet
Zeker in het begin willen we precies zien wat er gebeurt. Per vraag bewaren we de letterlijke invoer aan het model, de zoektreffers met hun score, het antwoord, de tokens en de kosten. In het beheer is er per organisatie een AI-dashboard met de totalen per dag, en een duim omhoog of omlaag laat zien waar de handleiding nog iets mist.
Daarnaast is er een vaste set van 50 vragen met het scherm dat in het antwoord hoort. De eerste meting: bij 42 van de 50 vragen vond het zoeken het juiste scherm. Elke vraag die in de praktijk misgaat, komt erbij. Zo vergelijken we straks modellen op feiten.
Voor de gebruiker staat de assistent als poppetje rechtsonder in beeld. Klik je erop, dan opent hij als paneel naast de pagina, zoals een AI-hulp in Word of Excel. De knoppen van het scherm blijven gewoon bereikbaar.
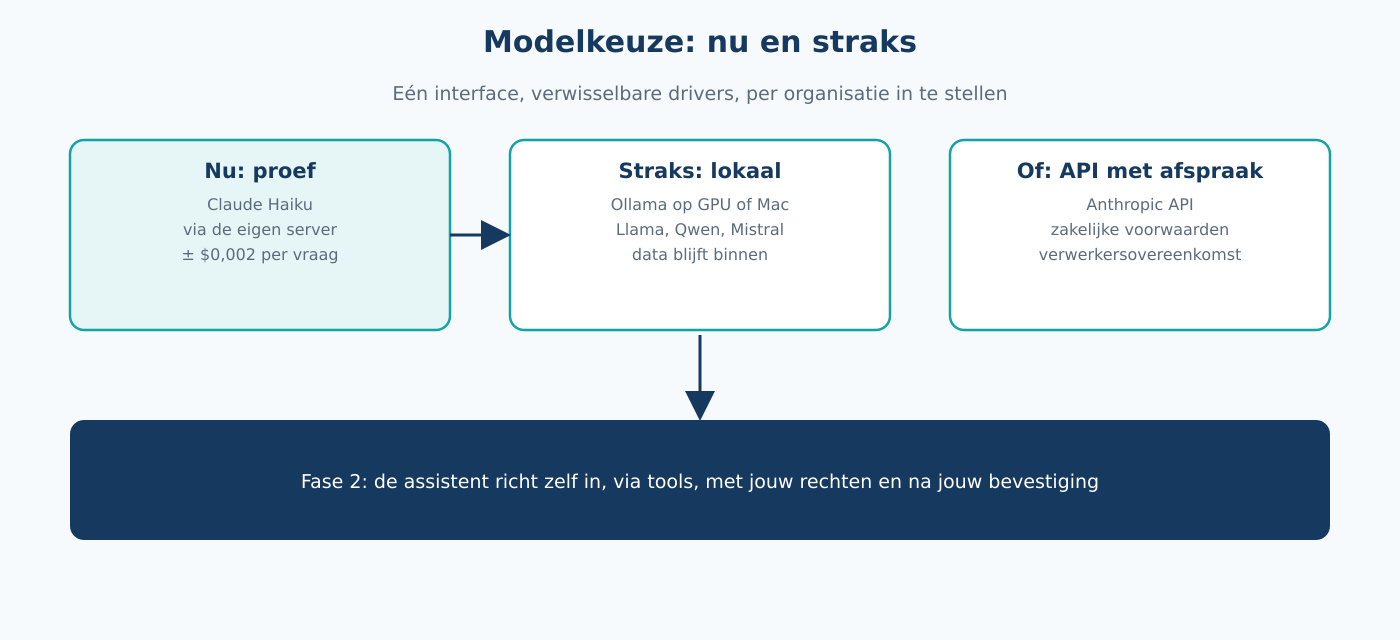
Modelkeuze: nu en straks
Het taalmodel zit achter één interface met verwisselbare drivers. Welke driver een organisatie gebruikt, stellen we per organisatie in. Zoeken, rechten en links veranderen niet als we van model wisselen.
- Nu, de proef: Claude Haiku van Anthropic, via onze eigen server. Snel en goedkoop: ongeveer $0,002 per vraag.
- Straks, lokaal: een open source model zoals Llama, Qwen of Mistral via Ollama, op een machine met een stevige videokaart of een Mac. Dan verlaat er niets de eigen omgeving. De embeddings draaien nu al lokaal.
- Of via een API met afspraken: de zakelijke API van Anthropic met een verwerkersovereenkomst, voor organisaties die dat willen.
De assistent is een aparte module. Wij zetten hem per organisatie aan, en de organisatie bepaalt zelf per rol wie hem mag gebruiken.
Volgende stap
Nu wijst de assistent de weg. In de volgende fase gaat hij ook zelf inrichten: "maak een jeugdabonnement van 12,50 per maand". Dat gaat dan via dezelfde acties als in de app, met jouw rechten, en pas na jouw bevestiging. Alles komt in de audit trail.
We bouwen het zo veel mogelijk met open source onderdelen: PostgreSQL, pgvector, Ollama, Laravel en Docker. Leuk werk.
#AI #RAG #pgvector #PostgreSQL #Ollama #Embeddings #Claude #LLM #OpenSource #Laravel #SaaS #SportsTech #GripOpSport